
遅いデータベースクエリはアプリのパフォーマンスをじわじわと蝕み、ユーザーを苛立たせ、インフラコストを膨らませます。これら5つの実証済みテクニックでレイテンシのボトルネックを解消し、ユーザーが期待する高速でレスポンシブな体験を提供しましょう。
データベース最適化を簡素化するアプローチの一つが、Adaloを使った開発です。AdaloはデータベースBBBBBBBBB駆動のウェブアプリ、そしてネイティブのiOS・Androidアプリを一つのバージョンで構築し、Apple App StoreとGoogle Playに公開できるノーコードアプリビルダーです。Adaloの組み込みデータベースはAPIレイテンシがゼロで、インフラはキャッシュとクエリ最適化を自動的に処理するため、手動のデータベースチューニングではなくアプリに集中できます。
既存システムを最適化する場合でも、新しいMVPをリリースする場合でも、アプリストアに素早く公開することでプッシュ通知とネイティブパフォーマンスにより最大の観客にリーチできます。データベースクエリを高速化する方法を説明します。
データベースのクエリレイテンシはアプリケーションのパフォーマンスを低下させ、ユーザーを苛立たせ、コストを増大させます。シンプルな内部ツールから数千のユーザーを持つ顧客向けアプリまで、遅いクエリはシステム全体に影響するボトルネックを作り出します。解決策を説明します:
- インデックス作成:
WHERE、JOIN、ORDER BY句の列をターゲットにしてインデックスでデータ取得を高速化。書き込み操作の遅延を防ぐため過剰なインデックスを避ける。 - 効率的なクエリ:
SELECT *を避け、インデックス使用のためWHERE条件を最適化し、不要なJOINやサブクエリを最小限に。 - キャッシュ:RedisやMemcachedなどのツールを使ってよくアクセスされるデータをメモリに保存しデータベース負荷を低減。
TTLでキャッシュデータを新鮮に保つ。 - パーティショニング:大きなテーブルを小さく分割するかプラットフォーム間でデータを同期して(水平または垂直)、大規模データセットのクエリパフォーマンスを向上。
- クエリ実行計画:実行計画を分析してシーケンシャルスキャンやディスクスピルなどのボトルネックを特定。それに応じてインデックスとクエリ構造を調整。
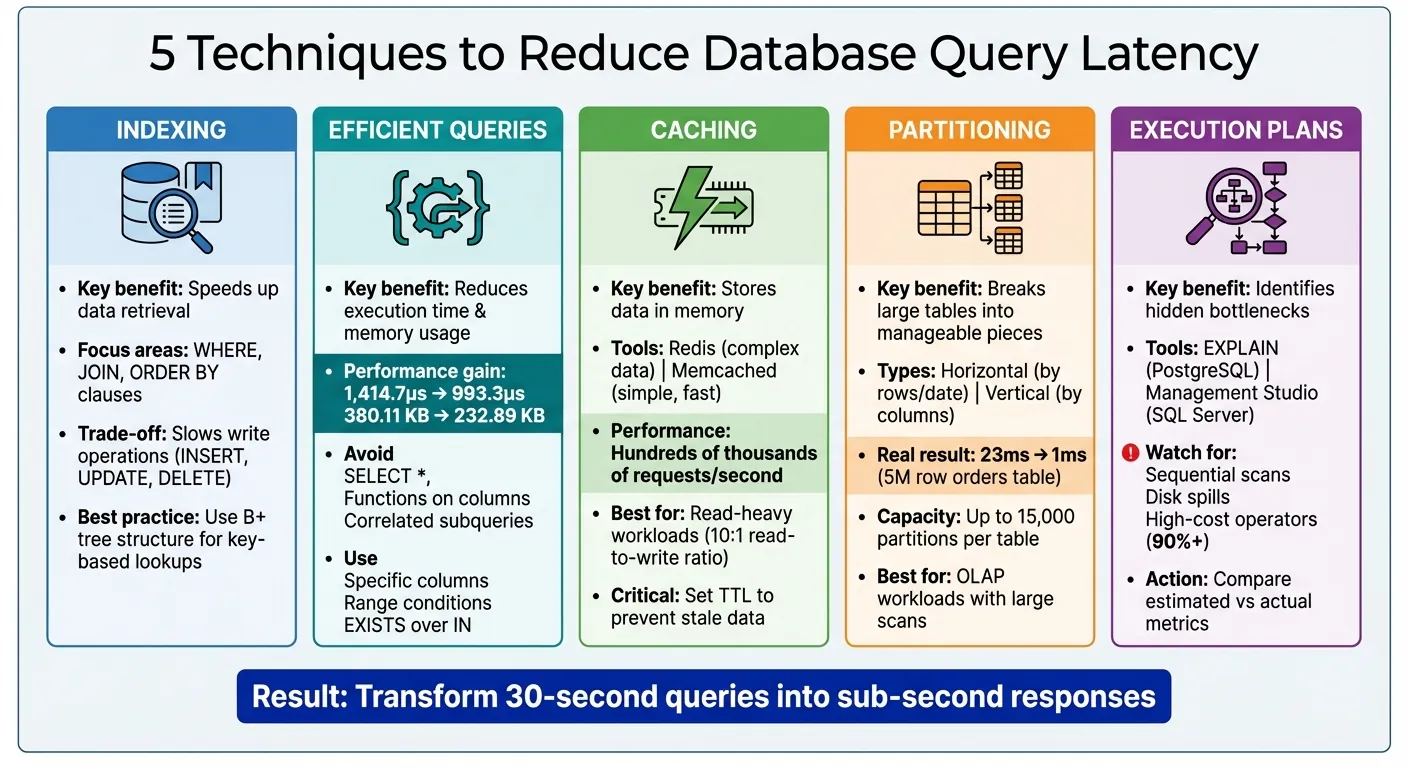
データベースクエリレイテンシ最適化:5つの主要手法の比較
1. データベースインデックスを活用する
データベースのインデックスは本の索引のようなもので、テーブル内の必要な行を直接指し示すショートカットとして機能します。これによりデータベースエンジンがすべての行をスキャンすることを防ぎ、データ取得を大幅に高速化します。ほとんどのインデックスは素早いキーベースの検索のために設計されたB+ツリー構造に基づいています。適切なインデックス設定は、特にアプリのデータベース統合オプションを評価する際にデータベースクエリを最適化するための重要なステップです。
WHERE、JOIN、ORDER BY句でよく使われる列にインデックスを付けることに集中してください。たとえばカバリングインデックスは必要なすべての列を直接取得でき、不要な入出力操作を削減します。
シンプルなクエリには単一列インデックスで十分なことが多いです。ただし、複数の条件を持つクエリには複合インデックスが効果的です。複合インデックスを作成する際は、等値フィルタから始め、次に範囲フィルタ、そして列の識別性を考慮して列を戦略的に並べてください。
インデックスはSELECT操作を高速化しますが、INSERT、UPDATE、DELETEなどの書き込み操作が遅くなるというトレードオフがあります。不要なオーバーヘッドを避けるため、インデックスの使用状況を監視し、価値を追加しないものは削除してください。
「一般的な設計上の誤りは、'オプティマイザに選択肢を与える'という目的で多くのインデックスを投機的に作成することです。過剰なインデックスはデータ変更を遅くし、競合の問題を引き起こす可能性があります。」 - Microsoft SQL Server Index Design Guide
インデックス作成のベストプラクティス
インデックスを実装する際は以下のガイドラインを考慮してください:
- 主キーはほとんどのデータベースシステムで自動的にインデックスが付けられます
- JOINで使用される外部キーはインデックス作成により大幅に恩恵を受けます
- 高いカーディナリティを持つ列(多くのユニークな値)は少ない独自値の列よりも優れたインデックス候補です
- 書き込みオーバーヘッドのみを追加する未使用のインデックスを特定するために定期的に監査してください
AdaloのようなAI搭載のアプリビルダーはこの複雑さの多くを自動的に処理します。2026年のインフラ刷新により、データベース操作は以前より3〜4倍高速になり、システムはアプリのニーズに合わせてインフラをスケールします。つまり、有料プランではレコード制限がありません。これにより、ほとんどの一般的なユースケースではインデックスを手動で最適化する必要がなくなります。
2. より効率的なクエリを作成する
クエリの構造はパフォーマンスを左右します。まずSELECT *の使用を避けてください。代わりに実際に必要な列のみを指定します。たとえば顧客データベースでIDと名前とメールアドレスのみが必要な場合、その3つのフィールドだけをリクエストしてください。不要な列を取得するとメモリと帯域幅を無駄にします。
クエリの構造はインデックス作成と同様に重要です。ORM(オブジェクトリレーショナルマッパー)でのフルエンティティ取得は大きなオーバーヘッドを追加することがあります。あるベンチマークでは、ノートラッキングクエリに切り替えることで実行時間が1,414.7マイクロ秒から993.3マイクロ秒に削減され、メモリ使用量が380.11 KBから232.89 KBに削減されたことが示されました。このオーバーヘッドを避けるには、ORM内のプロジェクション(EF Coreの.Select()やDjangoの.values()など)を使用して必要なフィールドのみを取得してください。
WHERE条件の最適化
WHERE条件を最適化する際は、書き方に注意してください。WHERE YEAR(hire_date) = 2020のような列に対する関数はインデックスを効果的に使用できません。代わりにWHERE hire_date >= '2020-01-01' AND hire_date < '2021-01-01'のような範囲ベースの条件を使用してください。このアプローチにより「SARG能力」(Search ARGument-ability)が維持され、クエリでインデックスを活用できます。同様に、LIKEクエリでの先頭ワイルドカードパターンはテーブル全体スキャンを強制するため避けてください。
「クエリが速く動作するかどうかの主な決定要因は、適切な場所でインデックスを適切に使用するかどうかです。」
– Microsoftドキュメント
JOINとサブクエリの削減
不要なJOINとサブクエリの使用を減らしてください。相関サブクエリ(外部クエリに依存するもの)は結果セットの各行に対して一度実行されるため特に問題です。可能な限り標準的なJOINに置き換えてください。データの存在を確認する場合はINの代わりにEXISTSを使用してください。EXISTS句は一致が見つかるとすぐに処理を停止するため、はるかに効率的です。
Ada(AdaloのAIビルダー)を使うと、やりたいことを説明するだけでアプリを生成してくれます。Magic Startは説明から完全なアプリの基盤を作成し、Magic Addは自然言語での指示で機能を追加します。
SQLを直接書かずにアプリを構築する場合、AdaloのビジュアルインターフェースはこれらD最適化を抽象化します。Magic AddなどのAIアシスト機能により、必要なデータを自然言語で説明でき、システムが効率的なクエリを自動的に生成します。これはパフォーマンスを理解せずにクエリ最適化を深く探求したくない非技術系ビルダーに特に価値があります。
3. 頻繁に使用されるクエリをキャッシュする
キャッシュはアプリケーションにメモリブーストを与えるようなものです。データベースを繰り返しクエリする代わりに、頻繁にアクセスされるデータをメモリに保存し、情報を取得するまでの時間を短縮します。これによりディスクアクセスに伴う遅延(最良の場合でも2桁のミリ秒がかかる)を回避できます。
キャッシュに使われる人気のツールはRedisとMemcachedの2つです。Redisは複雑なデータ構造を処理できること、ディスク永続化オプションがある点で際立っています。一方、Memcachedはシンプルで軽量で、純粋に高速キャッシュのために設計されています。その力を示すために、単一のインメモリキャッシュノードは毎秒数十万リクエストを処理できます。
キャッシュアサイドパターン
最も一般的なキャッシュ手法はキャッシュアサイド(遅延読み込みとも呼ばれる)です。仕組みはこうです:アプリケーションはまずキャッシュを確認します。データがない場合(「ミス」)、データベースをクエリしてデータを取得し、キャッシュを更新します。この手法は、データが書き込まれる頻度の10倍以上読み込まれる読み取り中心のシナリオに特に効果的です。この戦略と以前のクエリ最適化技術を組み合わせることで、データベースへの負担を大幅に削減できます。
古いデータが残らないよう、キャッシュデータには常にTTL(有効期限)を設定してください。Redisを使用している場合は、データベースの行を保存するためにハッシュの使用を検討してください。このアプローチにより、JSONブロブ全体を処理することなく個別のフィールドを更新できます。さらにキャッシュヒット率を監視してください。低い比率はキャッシュが効果的に使用されていないことを意味し、データベースの負荷を軽減することなくメモリを無駄にします。
「データベースの速度とスループットは、アプリケーション全体のパフォーマンスに最も影響する要因になりえます。」 – AWS
キャッシュを実装するタイミング
すべてのアプリケーションが専用のキャッシュレイヤーを必要とするわけではありません。以下の場合にキャッシュの実装を検討してください:
- 最適化にもかかわらずデータベースクエリが一貫して遅い
- 同じデータが複数のユーザーから繰り返しリクエストされている
- アプリがデータベースを圧倒するトラフィックの急増を経験している
- 読み取り操作が書き込み操作を大幅に上回っている
Adaloのモジュラーインフラはプラットフォームレベルでキャッシュを処理するため、プラットフォーム上に構築されたアプリは手動のキャッシュ設定なしに最適化されたデータ取得の恩恵を受けられます。システムは99%以上の稼働率で1日2,000万件以上のデータリクエストを処理しており、組み込みのパフォーマンス最適化の有効性を示しています。
4. 大規模データセットをパーティショニングする
テーブルが数百万行に膨らむと、最もよく最適化されたクエリでも遅くなり始めることがあります。パーティショニングはこれに対処する方法を提供し、大きなテーブルをパーティションと呼ばれるより小さく管理しやすい部分に分割しながら、論理的には単一テーブルとして扱います。これによりデータベースエンジンはパーティション排除(クエリ中に無関係なパーティションをスキップする)を使用でき、スキャンする必要があるデータ量を大幅に削減できます。
水平パーティショニングと垂直パーティショニング
データを分割するには主に2つの方法があります:水平パーティショニングと垂直パーティショニングです。
- 水平パーティショニングは日付や地域などの特定の列に基づいて行でテーブルを分割します。たとえば売上テーブルを月ごとのチャンクに分割できます。この方法は時系列データや特定の範囲でフィルタリングするクエリが多いシナリオに特に適しています。
- 一方垂直パーティショニングは列を分離します。多くのフィールドを持つ幅広いテーブル、特に少数の列のみが定期的にアクセスされる場合に最適です。たとえば、大きなBLOBやめったに使用されないフィールドを別のテーブルに移動できます。
実例として:Airtableデータベースの500万行の注文テーブルを月ごとにパーティショニングすることでクエリ時間が23msからわずか1msに削減されました。SQL Serverなどの現代的なデータベースエンジンはテーブルあたり最大15,000パーティションを処理できます。ただし、過剰なパーティショニングはメモリ使用量の増加につながり、クエリが複数のパーティションをスキャンする場合はパフォーマンスを低下させる可能性があります。
| パーティショニングタイプ | 手法 | 最適な用途 |
|---|---|---|
| 水平 | 行を分割(日付やID範囲などによる) | 範囲ベースクエリを持つ大規模データセット |
| 垂直 | 列を分割(BLOBを頻繁にアクセスするフィールドから分離するなど) | 少数の列のみが定期的にクエリされる幅広いテーブル |
適切なパーティションキーの選択
パーティショニングを効果的に機能させるには、WHERE句でよく使用される列を選択してください。これによりデータベースがパーティション排除を最大限に活用できます。さらに、メンテナンスタスクを改善するためにインデックスをパーティショニングスキームに合わせてください。パーティショニングは通常1行を取得するOLTPシステムよりも、大規模なスキャンを伴うOLAPワークロードに特に適しています。
大規模データセットを扱うアプリビルダーにとって、Adaloのインフラは現在アプリのニーズに合わせてスケールし、有料プランではデータベースレコードの上限がありません。適切なデータリレーションシップの設定により、プラットフォーム上に構築されたアプリは月間100万アクティブユーザーを超えてもパフォーマンスを維持できます。これにより、レコード制限があるプラットフォームで必要となる手動のパーティショニング戦略が不要になります。
5. クエリ実行計画を確認する
インデックス作成とクエリのリファクタリングに取り組んだら、実行計画を深く見ることでクエリパフォーマンスについてより深いインサイトが得られます。よく最適化されたクエリでも予期しないボトルネックが発生する可能性があり、実行計画はデータベースがクエリをどのように処理するかを明らかにするのに役立ちます。インデックスの使用状況、JOINの方法、ソート操作などの詳細を提供します。
EXPLAINと実行計画ツールの使用
PostgreSQLでは、EXPLAINとEXPLAIN ANALYZEが非常に有用です。EXPLAINは推定コストを提供し、EXPLAIN ANALYZEは行数や実行時間などの実際のパフォーマンスメトリクスを追加します。これらを比較することで、古い統計情報や最適でないインデックスを示す不一致を見つけられます。
注目すべき点
実行計画を分析する際は、大きなテーブルでの「Sequential Scan」パターンに注目してください。これは多くの場合インデックスを追加することでパフォーマンスが向上することを示します。スキャン後に大部分の行を破棄するフィルタ条件にも注意してください。これらは「Index Cond」操作に変換することで恩恵を受ける可能性があります。もう一つの危険信号はソートまたはハッシュ操作がディスクにスピルすることで、クエリのレイテンシを大幅に増加させる可能性があります。
「Sort」や「Hash Join」などの単一のオペレータがクエリコストの90%を占める場合、最適化の明確なターゲットです。一時的に特定のプランナーオプションを無効にして代替のJOIN戦略をテストし、実際にパフォーマンスが向上するかどうかを確認することもできます。暗黙のデータ型変換に関する警告にも注意してください。これらはエンジンが各行を個別に処理することを強制し、インデックスの効率を損なう可能性があります。
自動化されたパフォーマンス分析
実行計画を手動で分析することを好まない方には、AdaloがX-Rayを提供しています。これはユーザーに影響を与える前にパフォーマンスの問題を特定するAI機能です。このパフォーマンス監視への積極的なアプローチにより、データベースの内部を深く掘り下げることなくボトルネックを発見して修正できます。この機能はスケーリングに関する潜在的な懸念を浮き彫りにし、最適化を提案するため、アプリケーションをスケールする非技術系ビルダーに特に価値があります。
アプリビルダーのデータベースアプローチ比較
アプリ構築プラットフォームを選択する際、データベースのパフォーマンスとスケーラビリティを主要な考慮事項にすべきです。異なるプラットフォームはデータのストレージとクエリ最適化を根本的に異なる方法で処理します。
| プラットフォーム | データベースアプローチ | レコード制限 | 開始価格 |
|---|---|---|---|
| Adalo | 組み込み+外部接続 | 有料プランで無制限 | 月額36ドル |
| Bubble | Workload Units付き組み込み | Workload計算による制限 | 月額69ドル |
| Glide | スプレッドシートベース | 制限あり、追加料金発生 | 月額60ドル |
| FlutterFlow | 外部のみ(ユーザー管理) | 外部プロバイダーによる | 月額70ドル+データベースコスト |
まとめ
データベースクエリのレイテンシを削減することは速度の改善とスケーラビリティの確保について取り組むことです。インデックス作成、効率的なクエリの作成、キャッシュ、パーティショニング、実行計画の確認などの技術により、30秒かかる遅いクエリを1秒未満の高速なクエリに変えられます。
ただし、メリットは速度だけではありません。合理化されたクエリはサーバーリソースの消費が少なく、月次コストを削減し、ユーザーベースの成長に伴ってより滑らかな体験を確保します。効率的なクエリはサーバーへの負荷を軽減し、Airtableの秒5リクエストという制限などのAPIレート制限に達することを回避するのにも役立ちます。今小さな調整を行うことで、後の大きな問題を防げます。
関連ブログ記事
- ノーコードアプリのパフォーマンスを最適化する8つの方法
- IBM DB2データを使ったアプリの作成方法
- ノーコードアプリのパフォーマンスを追跡する5つのメトリクス
- 大規模データセット向けノーコードアプリのスケーリング
よくある質問
他のアプリ構築ソリューションではなくAdaloを選ぶ理由は?
AdaloはAI搭載のアプリビルダーで、真のネイティブiOSおよびAndroidアプリを作成します。ウェブラッパーとは異なり、ネイティブコードにコンパイルされ、単一のコードベースからApple App StoreとGoogle Play Storeの両方に直接公開されます。
データベースクエリのレイテンシを削減する最も効果的な方法は?
適切なデータベースインデックス作成が多くの場合最も効果的な最初のステップです。インデックスはテーブル全体をスキャンする代わりに必要な行を直接指し示すショートカットとして機能します。最高のパフォーマンス向上のためにWHERE、JOIN、ORDER BY句でよく使用される列にインデックスを付けることに集中してください。
大規模データセットにはキャッシュとパーティショニング、どちらを使うべきですか?
頻繁にアクセスされるがあまり変わらないデータがある場合はキャッシュを使用してください。RedisやMemcachedは毎秒数十万のリクエストを処理できます。テーブルが数百万行に膨らみ、日付などの特定の範囲でフィルタリングするクエリがある場合はパーティショニングを使用してください。データベースが無関係なデータを完全にスキップできるようになります。
AdaloとBubble、どちらがよりお手頃ですか?
Adaloは月額36ドルから、有料プランでは無制限の使用量とレコード上限なしで利用できます。Bubbleは月額69ドルから、Workload Unitsによる使用量ベースの課金とレコード制限があります。Adaloはまた、公開済みアプリへの無制限の更新を含みますが、Bubbleには再公開の制限があります。

関連コンテンツ
App Store説明文を書くための5つのヒント
コア価値とキーワードを最初に示した簡潔でメリット重視のApp Store説明文で、検索の可視性とダウンロード数を向上させましょう。
DreamFactory:データベースAPI接続の簡素化
20種類以上のデータベース向けの安全なREST APIを自動生成し、RBAC、JWT、OpenAPIドキュメントを処理して、カスタムコーディングなしにレガシーシステムをアプリに接続します。
ノーコードアプリ向けデータベース統合オプション7選
プロトタイプからエンタープライズまで、使いやすさ・スケーラビリティ・コストの観点からノーコードアプリ向けの7つのデータベースオプションを比較します。

データ最適化でアプリの読み込み時間を短縮する方法
データ駆動の修正でアプリの読み込み時間を大幅短縮:コレクションの効率化、クエリ最適化、ページネーション・遅延読み込みの有効化、メディアの圧縮など。